

Une réalité complexe
Le monde phénoménal de la matière est particulièrement complexe. Aussi, les questions existentielles sont légitimes. Mais les réponses peuvent-elles être simples sans être simplistes, sommaires voire péremptoires ? Au risque d’induire…
Comment dès lors aborder tous les sujets existentiels et essentiels ?
L’image de cet article fait coexister la nature, l’eau et l’extrême modernité de data centers pour l’intelligence artificielle. Quelle ressource en eau a-t-elle consommé pour sa création par une IA ?
Une requête adressée à une intelligence artificielle consomme-t-elle vraiment une bouteille d’eau ?
Depuis quelques années, une affirmation spectaculaire circule régulièrement : utiliser une intelligence artificielle comme ChatGPT ferait « boire » d’importantes quantités d’eau aux data centers. On rencontre même parfois l’idée qu’une simple requête pourrait consommer une bouteille entière.
La réalité est beaucoup plus intéressante.
Car derrière cette bouteille se cache une véritable étude scientifique… mais aussi une succession de raccourcis.
La fameuse bouteille de 500 mL
L’une des principales sources de cette affirmation est l’étude Making AI Less “Thirsty”, initialement publiée sous forme de prépublication en 2023 par Pengfei Li, Jianyi Yang, Mohammad A. Islam et Shaolei Ren, puis publiée dans Communications of the ACM.
Les chercheurs y étudient notamment l’empreinte hydrique de GPT-3, un modèle de 175 milliards de paramètres.
Leur conclusion n’était pas :
« Une requête consomme 500 mL d’eau. »
Ils estimaient que GPT-3 pouvait consommer l’équivalent d’une bouteille de 500 mL pour environ 10 à 50 réponses de longueur moyenne, selon le lieu et le moment où le calcul était effectué.
Cela représente approximativement 10 à 50 mL par réponse dans les configurations étudiées.
Cette nuance est fondamentale.
Mais une deuxième l’est encore davantage : cette valeur n’était pas la mesure d’un compteur d’eau enregistrant la consommation physique d’une requête ChatGPT.
Il s’agissait d’une estimation d’empreinte hydrique, dépendant notamment de l’énergie nécessaire au calcul, du refroidissement du data center et de l’eau consommée pour produire l’électricité.
Enfin, l’étude portait sur GPT-3 et les infrastructures correspondant à cette génération technologique.
Le chiffre est donc intéressant historiquement et scientifiquement. Il ne constitue pas une constante physique applicable à toutes les intelligences artificielles actuelles.
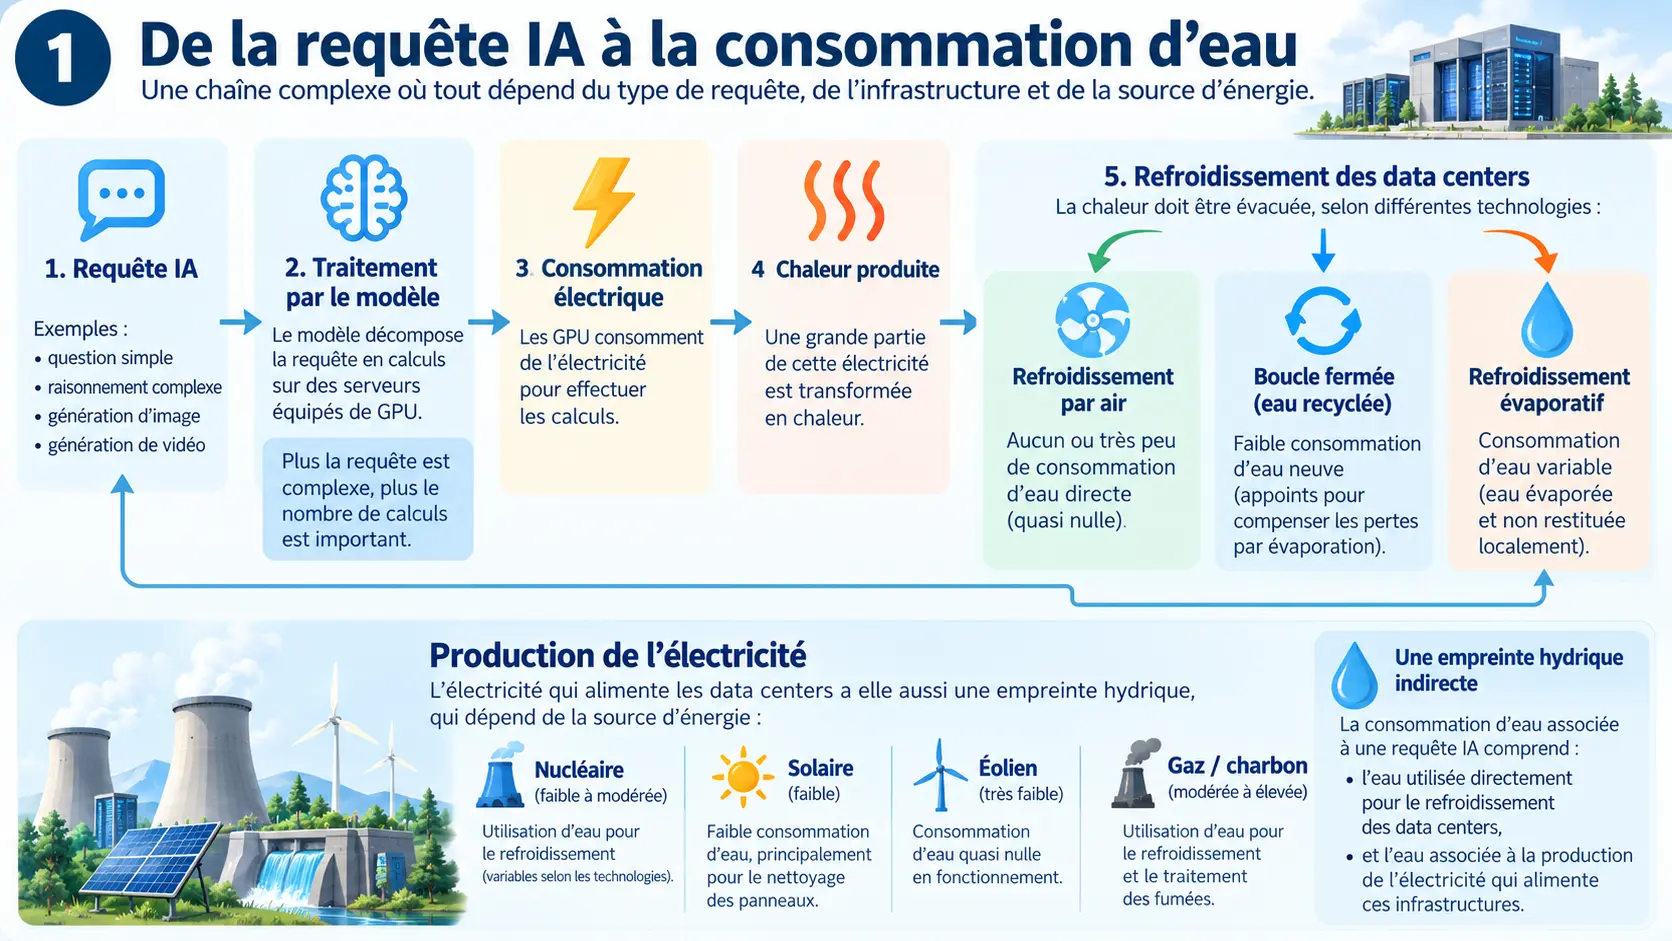
Pourquoi un data center a-t-il besoin d’être refroidi ?
Un ordinateur transforme presque toute l’électricité qu’il utilise en chaleur.
Un data center contenant des milliers de processeurs et de GPU doit donc continuellement évacuer cette énergie thermique.
Le principe général est extrêmement simple :
Électricité → calcul informatique → chaleur → transport de la chaleur → rejet dans l’environnement
Ce qui change d’un data center à l’autre est précisément la manière dont cette chaleur est transportée et évacuée.
Et c’est là que l’eau entre éventuellement en jeu.
1. Le refroidissement par air
La méthode la plus intuitive consiste à faire circuler de l’air autour des équipements.
L’air froid traverse les serveurs, récupère leur chaleur puis celle-ci est évacuée vers l’extérieur.
Lorsque les conditions climatiques le permettent, l’air extérieur peut directement contribuer au refroidissement. On parle alors notamment de free cooling ou d’air-side economizing.
Dans certaines configurations, la consommation directe d’eau nécessaire au refroidissement peut ainsi être très faible, voire nulle. Le Department of Energy américain souligne que l’utilisation directe de l’air extérieur peut réduire simultanément les besoins énergétiques et hydriques du refroidissement.
2. Les circuits d’eau fermés
L’eau transporte remarquablement bien la chaleur.
On peut donc faire circuler un liquide dans un circuit fermé :
serveurs → chaleur → liquide → échangeur → refroidissement → retour du liquide vers les serveurs
L’eau ne disparaît pas à chaque cycle.
Elle tourne continuellement dans le système, exactement comme l’eau d’un chauffage central transporte la chaleur des équipements vers les radiateurs — mais ici pour faire l’inverse : évacuer la chaleur.
Il faut remplir initialement le circuit et compenser d’éventuelles pertes ou opérations de maintenance, mais le principe n’implique pas en lui-même une consommation continue d’eau.
3. Les tours aéroréfrigérantes : là où l’eau est véritablement consommée
Une autre solution consiste à exploiter une propriété physique extrêmement efficace : l’évaporation de l’eau absorbe beaucoup d’énergie.
Une tour aéroréfrigérante évacue donc une partie de la chaleur en faisant évaporer de l’eau.
Cette fois, cette eau quitte réellement le circuit et doit être remplacée.
De plus, puisque les minéraux restent dans l’eau lorsque celle-ci s’évapore, une partie du circuit doit périodiquement être purgée afin d’éviter une concentration excessive en sels minéraux. Cette purge — appelée blowdown — augmente encore la quantité d’eau d’appoint nécessaire.
C’est essentiellement dans ce type de technologie que l’on rencontre une véritable consommation directe et continue d’eau.
4. Les systèmes hybrides
Il n’est pas nécessaire de choisir définitivement entre air et évaporation.
Certains systèmes utilisent un refroidissement sec lorsque les conditions climatiques le permettent et basculent vers un refroidissement évaporatif pendant les périodes les plus chaudes.
La consommation d’eau varie alors considérablement avec la saison et le climat.
Deux data centers techniquement très proches peuvent donc présenter des consommations d’eau très différentes simplement parce que l’un se trouve dans un climat frais et l’autre dans une région chaude.
5. Le refroidissement liquide directement sur les processeurs
L’arrivée de GPU extrêmement puissants pour l’intelligence artificielle favorise aujourd’hui le développement du direct-to-chip liquid cooling.
Au lieu de refroidir toute une salle pour maintenir les puces à bonne température, des plaques froides récupèrent directement leur chaleur.
Le liquide transporte ensuite cette chaleur jusqu’à un échangeur.
C’est beaucoup plus efficace pour transporter de fortes densités thermiques.
Et contrairement à ce que l’expression « refroidissement liquide » pourrait laisser croire :
refroidissement par liquide ne signifie pas consommation de liquide.
Tout dépend de la manière dont la chaleur est finalement rejetée dans l’environnement.
Microsoft exploite par exemple des architectures dans lesquelles l’eau circule en boucle fermée sans évaporation. L’entreprise indique que ses nouveaux data centers optimisés pour l’IA peuvent ainsi fonctionner avec zéro consommation d’eau pour le refroidissement en exploitation, même si le site conserve évidemment d’autres usages d’eau.
6. L’immersion
Une approche encore différente consiste à immerger directement les équipements électroniques dans un liquide diélectrique qui ne conduit pas l’électricité.
La chaleur passe alors directement :
composants électroniques → liquide → échangeur → système de rejet thermique
Là encore, le fait d’utiliser un liquide n’implique pas nécessairement une consommation d’eau.
De quelle eau parle-t-on ?
C’est probablement la distinction la plus importante de tout le débat.
Eau prélevée
C’est l’eau retirée d’une rivière, d’une nappe, d’un réseau ou d’une autre ressource.
Elle peut ensuite être restituée.
Prélever 1 litre ne signifie donc pas nécessairement consommer 1 litre.
Eau consommée
C’est l’eau qui n’est pas immédiatement restituée à la ressource initiale, notamment parce qu’elle a été évaporée.
Pour analyser la pression exercée sur une ressource locale, cette distinction est fondamentale.
Eau directement consommée par le data center
Elle peut être utilisée pour le refroidissement évaporatif, l’humidification, les purges de circuits ou différents usages du bâtiment.
C’est l’eau physiquement utilisée sur le site.
Eau indirectement consommée
L’électricité alimentant le data center possède elle-même une empreinte hydrique.
Certaines centrales thermiques utilisent de l’eau pour leur refroidissement. L’hydroélectricité pose encore d’autres questions d’attribution de l’évaporation des réservoirs.
L’empreinte hydrique attribuée à un calcul informatique peut donc inclure de l’eau qui n’a jamais pénétré dans le data center.
Une étude de 2025 du Lawrence Berkeley National Laboratory souligne précisément que l’empreinte hydrique d’une charge informatique doit être analysée en tenant compte à la fois de l’eau directe et de celle associée à la production électrique.
Toutes les requêtes adressées à une IA ne se ressemblent pas
Le mot « requête » est particulièrement trompeur.
Prenons deux questions :
« Quelle est la capitale du Pérou ? »
et :
« Analyse ces cinquante pages, compare les hypothèses, recherche les contradictions et rédige-moi une synthèse argumentée. »
Administrativement, chacune peut être comptée comme une requête.
Informatiquement, elles n’ont presque rien de comparable.
L’énergie nécessaire dépend notamment :
- du modèle utilisé ;
- du nombre de données ou tokens fournis en entrée ;
- du nombre de tokens générés ;
- de la complexité du modèle ;
- du matériel utilisé ;
- de son taux d’utilisation ;
- de l’efficacité du système qui sert simultanément les demandes de nombreux utilisateurs.
Les modèles génératifs ont par ailleurs des profils de consommation différents selon les tâches. Les travaux comparant différentes familles de modèles montrent que les architectures génératives généralistes peuvent demander beaucoup plus d’énergie que des modèles spécialisés réalisant certaines tâches précises.
Une réponse textuelle courte, un long raisonnement, la génération d’une image et celle d’une vidéo ne peuvent donc pas être raisonnablement ramenés à une même « consommation par requête ».
Combien d’eau consomme réellement une requête IA ?
La réponse scientifiquement la plus rigoureuse est peut-être frustrante :
cela dépend.
Mais nous disposons désormais de mesures et d’estimations permettant de comprendre les ordres de grandeur.
GPT-3 : environ 10 à 50 mL dans l’étude à l’origine de la controverse
Comme nous l’avons vu, l’étude de Li et ses collègues aboutissait à l’équivalent d’environ 500 mL pour 10 à 50 réponses moyennes dans les scénarios considérés.
Cela représente environ :
10 à 50 mL par réponse.
Mais cette estimation associe plusieurs composantes de l’empreinte hydrique et concerne GPT-3 et les infrastructures prises comme références par les chercheurs.
En 2025, Google a publié une analyse réalisée sur son infrastructure réelle servant Gemini.
Pour un prompt texte médian de Gemini Apps en mai 2025, Google estime 0,26 mL :
0,24 Wh d’électricité
et
0,26 mL d’eau.
Cela représente approximativement cinq gouttes.
Mais il serait tout aussi trompeur de transformer 0,26 mL en nouvelle constante universelle.
Google précise explicitement qu’il s’agit d’une analyse ponctuelle portant sur mai 2025, calculée notamment à partir de la consommation énergétique mesurée et de la Water Usage Effectiveness moyenne de sa flotte en 2024.
L’entreprise indique également que ces résultats ne représentent pas tous les prompts Gemini, toutes les infrastructures ni leurs performances futures, et qu’ils n’ont pas fait l’objet d’une vérification indépendante par un tiers.
Microsoft en 2026 : 0 à 0,067 mL dans son estimation
Une étude publiée en 2026 et présentée par Microsoft estime que des requêtes typiques adressées à certains de ses grands modèles en production consomment environ 0,16 à 0,60 Wh d’électricité selon notamment leur longueur, le modèle et l’infrastructure.
L’entreprise en déduit une consommation d’eau de refroidissement comprise entre 0 et 0,067 mL par requête typique, avec une valeur médiane qu’elle décrit comme inférieure à une goutte.
Une fois encore, le périmètre et la méthode diffèrent des études précédentes.
Il serait donc scientifiquement incorrect de placer simplement :
50 mL → 0,26 mL → 0,067 mL
sur une courbe et d’en conclure que « l’IA consomme désormais mille fois moins d’eau ».
Les travaux ne mesurent pas exactement la même chose.
Pourquoi les chiffres peuvent-ils autant varier ?
Une publication scientifique du Lawrence Berkeley National Laboratory parue en 2025 apporte ici un résultat spectaculaire.
Les chercheurs ont étudié les facteurs déterminant la consommation d’eau par charge informatique.
Selon les configurations examinées, ils constatent des variations de consommation par charge dépassant un facteur : 10 000.
Oui : plus de dix mille fois.
Les principaux facteurs sont notamment :
l’efficacité du serveur → l’empreinte hydrique de l’électricité → le taux d’utilisation des serveurs → le système de refroidissement → l’efficacité globale du data center → le climat → la proportion de serveurs inactifs → l’âge du matériel.
Autrement dit, demander :
« Combien d’eau consomme une requête IA ? »
sans préciser le modèle, l’infrastructure, le lieu, le système de refroidissement et le périmètre de calcul revient un peu à demander :
« Combien consomme un voyage ? »
- En vélo ?
- En voiture ?
- En TGV ?
- En avion ?
- Sur 3 kilomètres ou sur 10 000 ?
Le mot voyage ne suffit pas à déterminer la consommation.
Le mot requête non plus.
Les data centers évoluent très rapidement
Il existe également un problème temporel dans le débat.
Les modèles évoluent, mais les infrastructures aussi.
Les processeurs deviennent plus efficaces. Les logiciels optimisent l’utilisation du matériel. Les serveurs peuvent traiter davantage de demandes simultanément. Le refroidissement liquide permet d’extraire directement la chaleur des GPU. Les températures des circuits peuvent être augmentées. Les systèmes secs et hybrides progressent.
Microsoft indique ainsi qu’environ 90 % de son parc de data centers détenus en propre en 2025 utilisait des systèmes de refroidissement à consommation d’eau faible ou nulle, et développe des architectures IA à boucle fermée sans évaporation d’eau pour le refroidissement.
Google rapporte de son côté que, sur les douze mois précédant son analyse de mai 2025, la consommation énergétique de son prompt texte Gemini médian avait été divisée par 33, tout en indiquant que la méthodologie et l’évolution du produit doivent être prises en compte dans l’interprétation de cette comparaison.
Cela montre à quel point une valeur datant de quelques années peut rapidement devenir peu représentative d’une infrastructure récente.
Mais cette amélioration spectaculaire par opération ne résout pas nécessairement le problème global.
Le paradoxe : consommer beaucoup moins… et davantage au total
Imaginons qu’une nouvelle génération d’IA nécessite dix fois moins d’énergie et d’eau pour effectuer le même travail.
Excellent progrès.
Mais si, parallèlement, son utilisation est multipliée par cent, la consommation totale peut continuer à augmenter.
C’est ce que l’on appelle généralement l’effet rebond.
L’amélioration de l’efficacité d’une technologie peut diminuer son coût, faciliter son utilisation et favoriser sa diffusion au point que l’augmentation des usages compense une partie — voire davantage — des économies obtenues individuellement.
C’est probablement là que se trouve une partie importante du véritable enjeu environnemental de l’IA.
Il ne suffit donc pas de demander :
« Combien consomme une requête ? »
Il faut également demander :
« Combien de requêtes allons-nous effectuer ? »
Et surtout :
« Quelle quantité totale de calcul informatique allons-nous demander à ces infrastructures ? »
Ni bouteille d’eau magique, ni IA sans impact
L’intelligence artificielle possède une empreinte environnementale réelle.
Elle nécessite des équipements, de l’électricité, des bâtiments, des systèmes de refroidissement et, dans certaines infrastructures, des quantités importantes d’eau.
À l’échelle d’un data center ou d’une région soumise au stress hydrique, cette consommation peut constituer un véritable enjeu local.
La minimiser serait aussi peu pertinent que l’exagérer.
Mais une requête d’intelligence artificielle ne possède pas une consommation d’eau intrinsèque.
Son empreinte dépend de ce qu’on demande à l’IA, du modèle utilisé, du nombre de calculs effectués, du matériel, du taux d’utilisation des serveurs, de l’efficacité du data center, de son système de refroidissement, de sa localisation, du climat, de l’électricité qui l’alimente et, enfin, de ce que l’étude choisit d’inclure sous le terme « consommation d’eau ».
La célèbre bouteille de 500 mL n’était donc pas une invention.
Mais elle n’a jamais signifié qu’une question posée à une intelligence artificielle faisait disparaître instantanément une bouteille d’eau.
Elle représentait une estimation réalisée dans un contexte technologique et méthodologique déterminé.
Depuis, les technologies ont considérablement évolué.
Et peut-être est-ce finalement cela que nous enseigne cette controverse :
avant de nous demander si un chiffre doit nous rassurer ou nous inquiéter, commençons par nous demander ce qu’il mesure réellement.
Des chiffres en perspective : un litre est-il toujours un litre ?
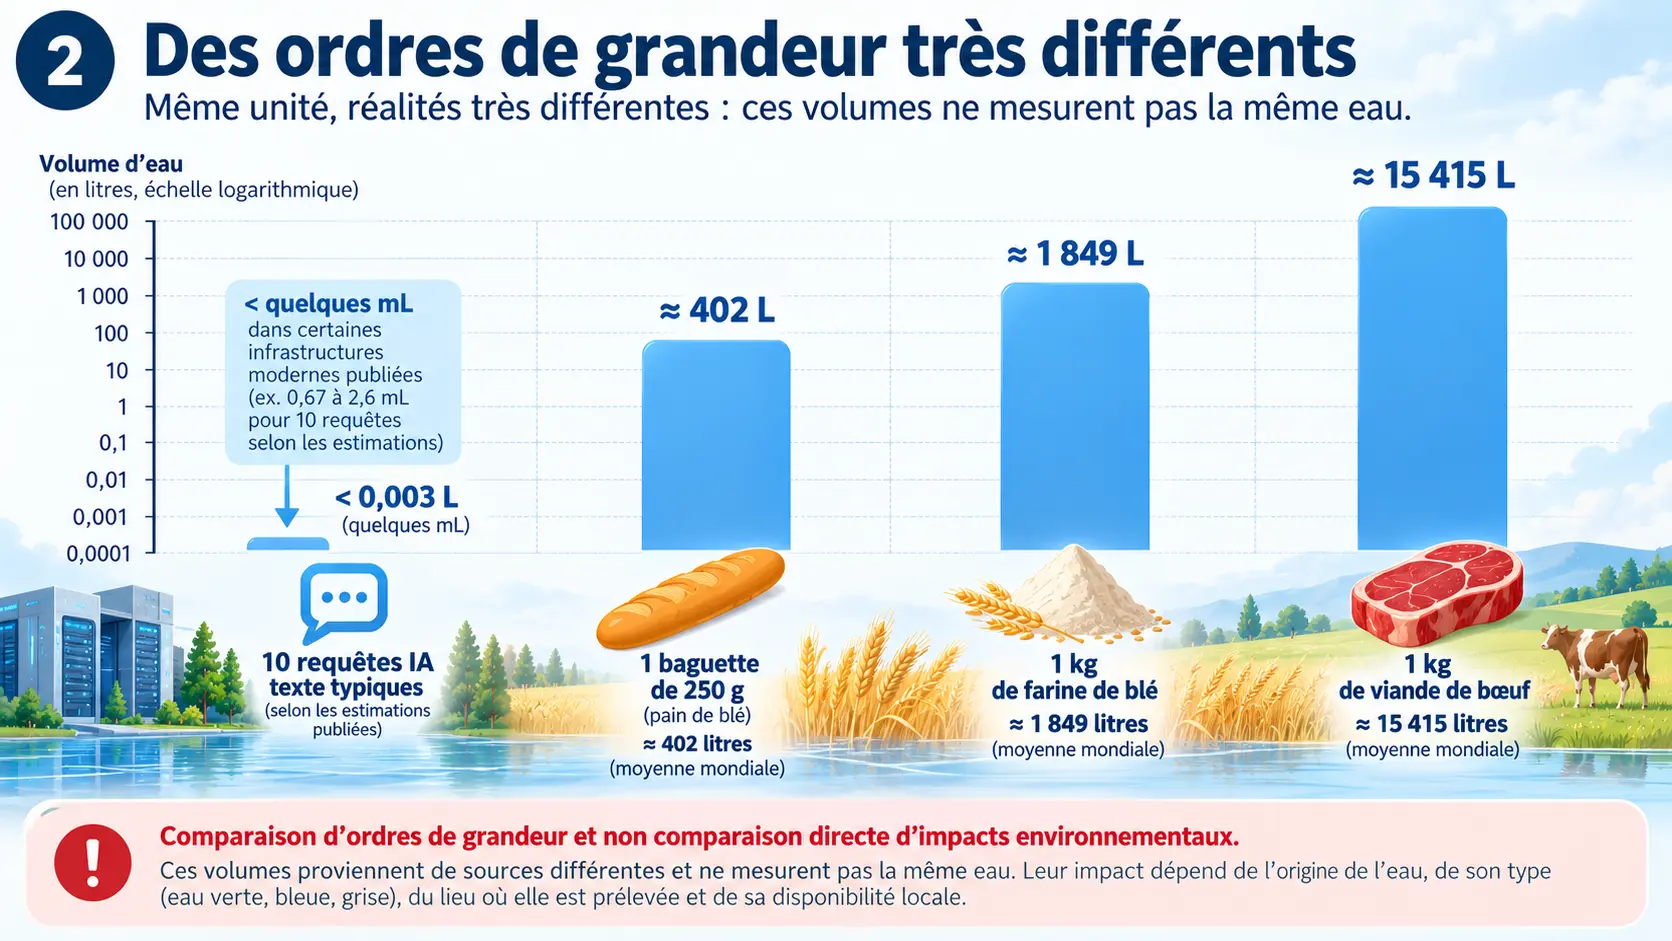
Quelques millilitres d’eau pour une requête d’intelligence artificielle. Environ 400 litres pour une baguette. Près de 1 850 litres pour un kilogramme de farine. Plus de 15 000 litres pour un kilogramme de viande de bœuf.
Présentés ainsi, ces chiffres sont spectaculaires.
Ils sont aussi potentiellement trompeurs.
Car additionner des litres ne suffit pas pour comparer des impacts sur la ressource en eau.
Quelques ordres de grandeur
Les travaux de Mekonnen et Hoekstra sur l’empreinte hydrique mondiale donnent les moyennes suivantes :
- 1 kg de viande de bœuf : environ 15 415 litres
- 1 kg de farine de blé : environ 1 849 litres
- 1 kg de pain de blé : environ 1 608 litres
Une baguette française de 250 g représenterait donc, en appliquant cette moyenne mondiale au pain, environ :
402 litres d’empreinte hydrique.
Ces chiffres sont des moyennes mondiales et peuvent varier considérablement selon le pays, le climat, les pratiques agricoles et l’origine des matières premières.
À première vue, la comparaison avec une utilisation de l’intelligence artificielle semble vertigineuse.
Google estimait en 2025 à 0,26 mL la consommation d’eau associée à son prompt texte Gemini médian dans le périmètre étudié.
Dix requêtes identiques représenteraient donc environ : 2,6 mL d’eau.
Microsoft estimait en 2026 entre 0 et 0,067 mL l’eau de refroidissement associée à une requête typique sur ses grands modèles de production, soit au maximum environ :
0,67 mL pour dix requêtes typiques.
Ces valeurs ne sont cependant ni directement interchangeables ni applicables à toutes les requêtes IA. Une requête complexe peut nécessiter davantage de calcul qu’une requête simple et les deux entreprises n’utilisent pas exactement le même périmètre de calcul. Les valeurs publiées sont donc des ordres de grandeur associés à des infrastructures particulières, pas une « consommation universelle » de l’intelligence artificielle.
Une comparaison qui semble alors écrasante
À titre purement illustratif :
- 10 requêtes texte IA typiques récentes : de moins de 1 à quelques millilitres selon les estimations publiées
- 1 baguette de 250 g : ≈ 402 litres
- 1 kg de farine de blé : ≈ 1 849 litres
- 1 kg de bœuf : ≈ 15 415 litres
On pourrait s’arrêter là et conclure que l’empreinte hydrique d’une requête IA est insignifiante par rapport à celle de notre alimentation.
Ce serait précisément reproduire l’erreur que nous essayons d’éviter depuis le début de cet article.
Car ces litres ne représentent pas la même chose.
Eau verte, eau bleue, eau grise
L’empreinte hydrique agricole distingue généralement trois catégories.
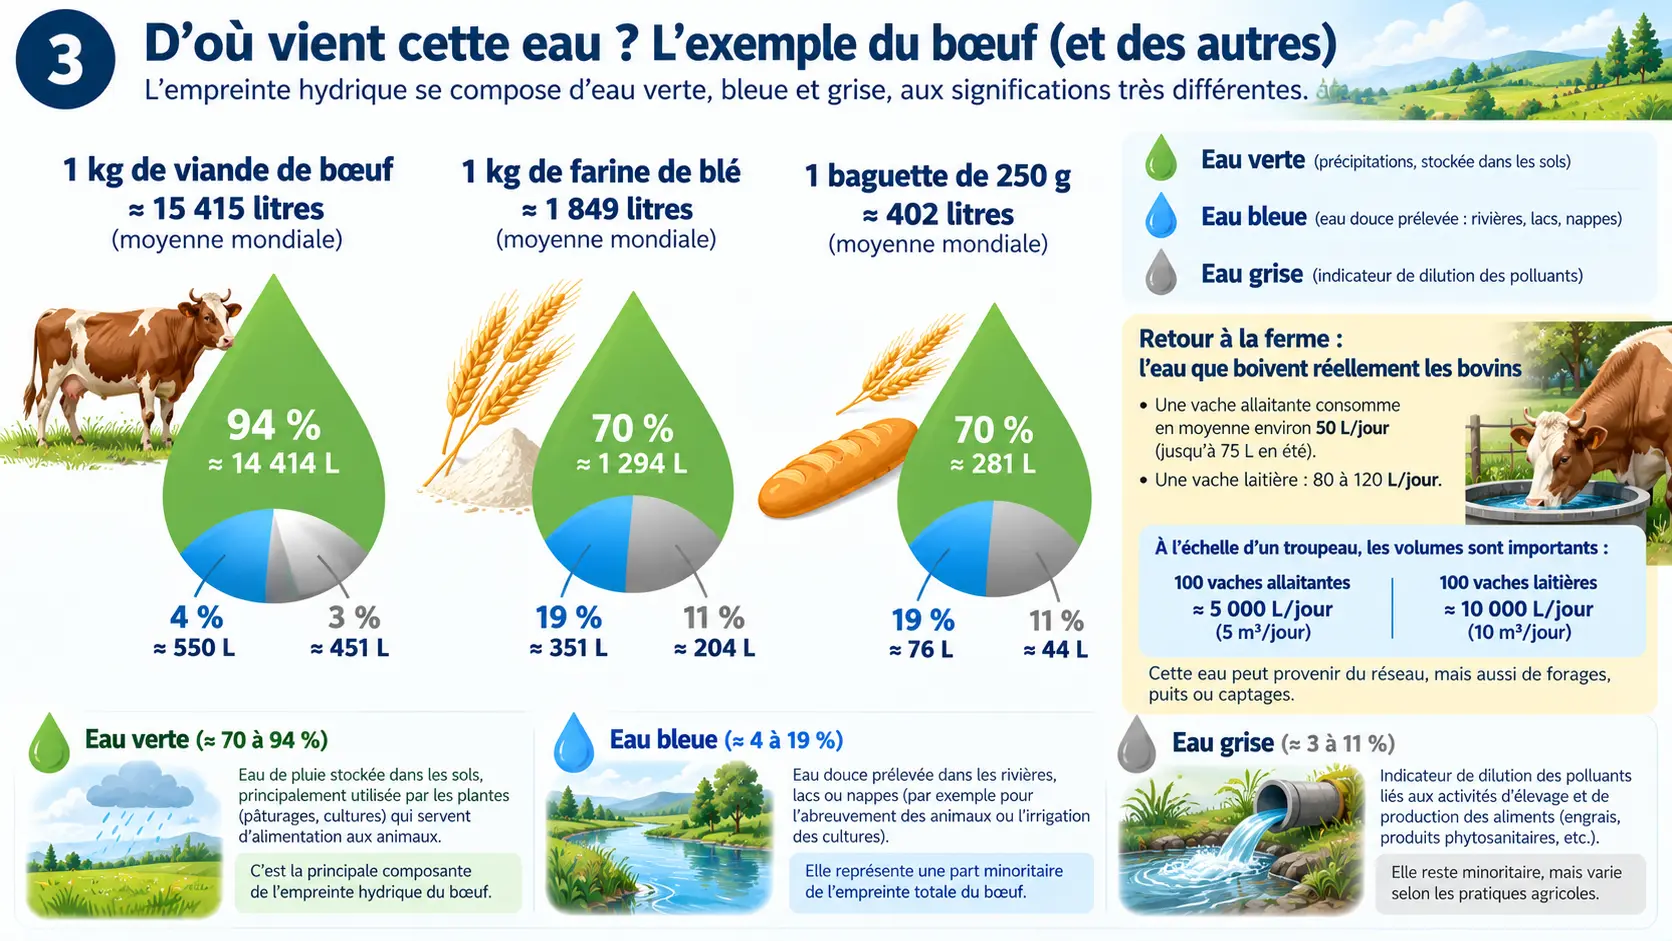
L’eau verte
C’est principalement l’eau des précipitations stockée dans les sols et utilisée par les plantes.
Elle constitue une part considérable de l’empreinte hydrique agricole.
Dans l’estimation mondiale du bœuf de Mekonnen et Hoekstra, sur les quelque 15 415 litres par kilogramme, environ :
- 14 414 litres sont de l’eau verte,
- 550 litres de l’eau bleue,
- 451 litres de l’eau grise.
Autrement dit, environ 94 % de l’empreinte hydrique calculée du bœuf est constituée d’eau verte.
Cela change considérablement la manière d’interpréter le fameux chiffre de 15 000 litres.
Il ne signifie évidemment pas que l’éleveur ouvre un robinet et prélève 15 000 litres d’eau potable pour fabriquer chaque kilogramme de viande.
Une très grande partie correspond à la pluie ayant permis aux pâturages et aux cultures destinées à l’alimentation animale de pousser.
L’eau bleue
Il s’agit de l’eau douce prélevée dans les rivières, les lacs ou les nappes souterraines.
C’est généralement cette eau qui pose le plus directement la question de la concurrence entre usages : eau potable, agriculture, industrie, écosystèmes, data centers…
Et son impact dépend fortement du lieu.
Prélever 1 000 litres dans un bassin abondamment alimenté en eau n’a pas les mêmes conséquences que prélever les mêmes 1 000 litres dans une nappe surexploitée en période de sécheresse.
L’eau grise
Elle est encore différente. Ce n’est pas nécessairement un volume d’eau physiquement consommé.
Il s’agit d’un indicateur théorique représentant le volume d’eau douce nécessaire pour diluer une pollution jusqu’à atteindre un niveau de qualité déterminé.
Voilà donc trois « litres » qui portent la même unité mais décrivent des réalités environnementales très différentes.
Et l’eau évaporée par un data center ?
Une autre subtilité apparaît.
Lorsqu’un data center utilise un refroidissement évaporatif, l’eau évaporée est comptabilisée comme eau consommée.
Pourtant, cette eau n’est évidemment pas détruite.
La molécule H₂O ne disparaît pas.
Elle rejoint l’atmosphère sous forme de vapeur, participe au cycle hydrologique puis pourra ultérieurement retomber sous forme de précipitations.
Pourquoi parle-t-on alors de « consommation » ?
Parce qu’elle cesse d’être disponible au lieu et au moment où elle a été prélevée.
L’enjeu est donc moins celui d’une disparition de l’eau à l’échelle planétaire que celui de sa disponibilité dans un espace et un temps déterminés.
Une eau prélevée dans un bassin soumis à un stress hydrique puis évaporée peut retomber ailleurs plusieurs jours plus tard.
Elle demeure dans le cycle de l’eau.
Mais elle n’est plus nécessairement disponible pour le bassin qui l’a fournie.
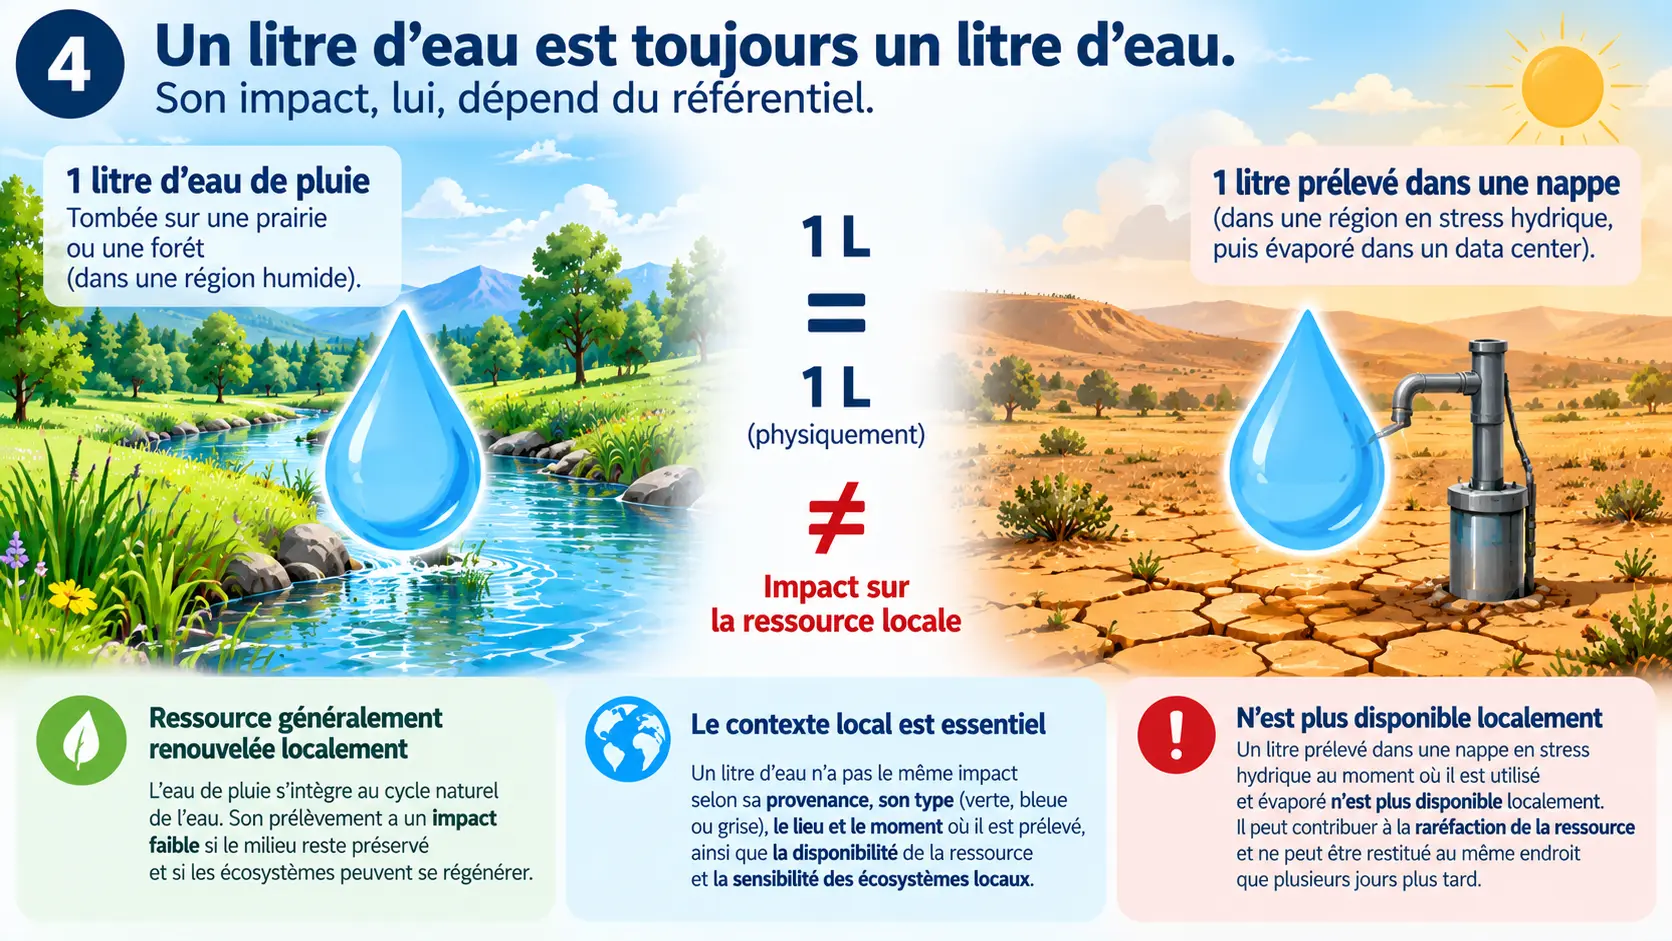
Le référentiel change tout
Prenons deux litres d’eau.
Le premier est constitué d’eau de pluie tombée naturellement sur une prairie française.
Le second est pompé dans une nappe souterraine déficitaire pour alimenter un système de refroidissement évaporatif dans une région aride.
Physiquement :
1 litre = 1 litre.
Du point de vue de la pression exercée sur la ressource locale :
1 litre ≠ 1 litre.
Il faut donc connaître non seulement le volume d’eau associé à une activité, mais également :
son origine — son type — sa localisation — la période du prélèvement — sa disponibilité locale — son devenir — et la méthode utilisée pour la comptabiliser.
C’est pourquoi les comparaisons spectaculaires doivent toujours être accompagnées de leur référentiel.
Alors, peut-on comparer une baguette et dix requêtes IA ?
Oui.
Mais pas pour déterminer laquelle serait « bonne » ou « mauvaise ».
Cette comparaison est intéressante pour une autre raison : elle montre à quel point un chiffre isolé peut perdre son sens lorsqu’on ignore ce qu’il mesure.
Une baguette possède une empreinte hydrique globale de l’ordre de plusieurs centaines de litres, mais une grande partie de cette empreinte provient de l’eau utilisée pour produire le blé et notamment des précipitations.
Une requête IA peut représenter une quantité beaucoup plus faible dans certaines infrastructures modernes, mais une partie de cette eau peut être prélevée puis évaporée localement dans une région où la ressource est éventuellement sous tension.
Comparer uniquement les volumes reviendrait donc à comparer des réalités différentes.
La véritable question n’est pas seulement :
« Combien de litres ? »
Mais :
« Quels litres, où, quand et avec quelles conséquences sur la ressource locale ? »
Un litre d’eau est toujours un litre d’eau.
Son empreinte, elle, dépend du référentiel dans lequel on le regarde.
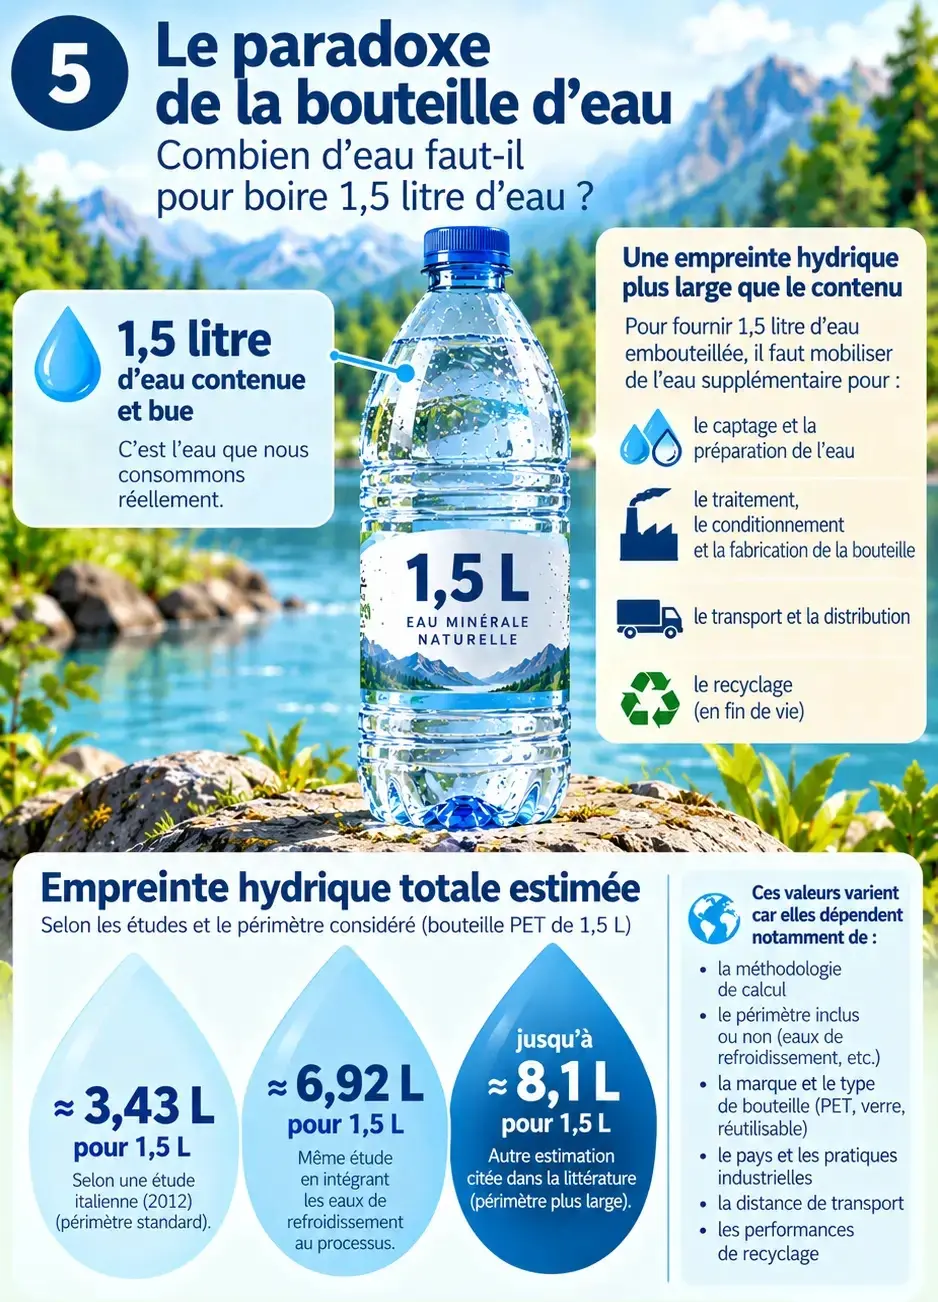
Même bouteille. Différents chiffres. Pourquoi ?
Parce que le périmètre de calcul change.
Une étude scientifique consacrée précisément à cette question, sur six marques italiennes en bouteilles PET, trouve pour 1,5 L d’eau livrée au consommateur une empreinte hydrique moyenne de 3,43 L : les 1,5 L contenus dans la bouteille + environ 1,93 L supplémentaires. Lorsque les auteurs ajoutent leur comptabilisation de l’eau de refroidissement, le résultat monte à 6,92 L. ScienceDirect
Une revue scientifique plus récente rappelle justement que les résultats dépendent fortement du périmètre, des pratiques industrielles et de la méthodologie. Elle cite notamment une estimation d’environ 8,1 L pour 1,5 L d’eau embouteillée en PET dans une autre comptabilisation, et des valeurs encore plus élevées dans d’autres pays. MDPI
En synthèse, à retenir
- Les data centers sont refroidis par air, par liquide ou par une combinaison des deux.
- Dans les boucles en circuit fermé, des volumes importants d’eau circulent continuellement : il s’agit d’un stock, pas d’une consommation. Pour donner une échelle, un Français consomme en moyenne 52 m3 par an. Eau France
- La chaleur doit ensuite être évacuée vers l’extérieur. Elle peut l’être par échange avec l’air, par refroidissement sec ou par évaporation d’eau. C’est principalement dans ce dernier cas qu’apparaît une consommation locale d’eau : l’eau évaporée quitte la ressource locale, mais n’est évidemment pas détruite à l’échelle planétaire.
- Les tours de refroidissement nécessitent également des purges pour limiter la concentration des sels et autres substances dans l’eau. Elles génèrent donc un volume d’eau rejetée qui doit être traité ou évacué.
- Il faut donc distinguer quatre notions : eau présente dans l’installation → eau qui circule → eau prélevée → eau effectivement consommée.
Réponse simple ou simpliste ?
Alors, combien d’eau aura consommé la réalisation de cet article — recherches, échanges avec l’IA, raisonnements et création de ses illustrations ?
Combien aura été prélevée ?
Combien aura été restituée localement ?
Combien aura été évaporée et rejoindra le cycle de l’eau ailleurs ou plus tard ?
Joker.
Pour répondre correctement à cette question… relisez l’article. 😉